TL;DR
Beluister genoeg gesprekken om de vraag te beantwoorden die u stelt. Vier gesprekken per agent per maand volstaan om te coachen, niet om te zeggen of een agent compliant is: bij 4 gescoorde gesprekken is een waargenomen 80% verenigbaar met alles tussen 34% en 97% (95%-Wilsoninterval). Vier gesprekken missen ook meestal zeldzame problemen: een probleem dat in 1 op 20 gesprekken voorkomt, wordt maar in 18,5% van de gevallen opgemerkt. Traditionele kwaliteitscontrole beoordeelt 2–5% van de interacties (Gartner). Hieronder zetten we daar cijfers op, met eenvoudige statistiek die u zelf kunt narekenen: waar een steekproef goed in is, wat analyse van 100% verandert, en hoe u alles scoort en toch de juiste gesprekken beluistert.
Kerncijfers
| Cijfer | Waarde | Bron |
|---|---|---|
| Aandeel van de geassisteerde interacties dat traditionele QA beoordeelt | 2–5% | Gartner |
| Contactcenters die 5 of meer gesprekken per agent per maand evalueren | 60% | SQM Group |
| Agents die zeggen dat de meeste van hun gesprekken nooit beluisterd worden | 81% | Solidroad State of CX 2026 (enquête van een leverancier, n = 500) |
| Kans dat 4 beluisterde gesprekken minstens één probleemgesprek bevatten, als 5% van de gesprekken een probleem heeft | 18,5% | Berekening Intract |
| Breedte van het 95%-betrouwbaarheidsinterval voor een agent met 80% op 4 gesprekken | 34% tot 97% | Berekening Intract (Wilsoninterval) |
| Benodigde gesprekken voor een marge van ±5 punten op een percentage voor het hele center | ~385 | Berekening Intract |
1. Wat de sector echt beluistert
De cijfers zijn consistent over de bronnen heen, ook al verschillen ze in de details.
- Gartner beschrijft traditionele QA als een controle van doorgaans 2% tot 5% van het geassisteerde servicevolume.
- SQM Group meldt dat 60% van de contactcenters vijf of meer gesprekken per agent per maand evalueert. Call Centre Helper noemt 3 tot 5 evaluaties per agent per maand als meest voorkomende bandbreedte en merkt op dat er geen sectorrichtlijnen voor die verhoudingen bestaan.
- De benchmark 2022 van COPC bij meer dan 900 leidinggevenden toont dat 58% agents wekelijks opvolgt en 63% de te beoordelen transacties willekeurig kiest.
- Aan de kant van de agents bleek uit een enquête van een leverancier uit 2026 bij 500 supportmedewerkers dat 81% zegt dat de meeste van hun gesprekken nooit beluisterd worden, en 37% dat dit voor slechts 0–10% wel gebeurt.
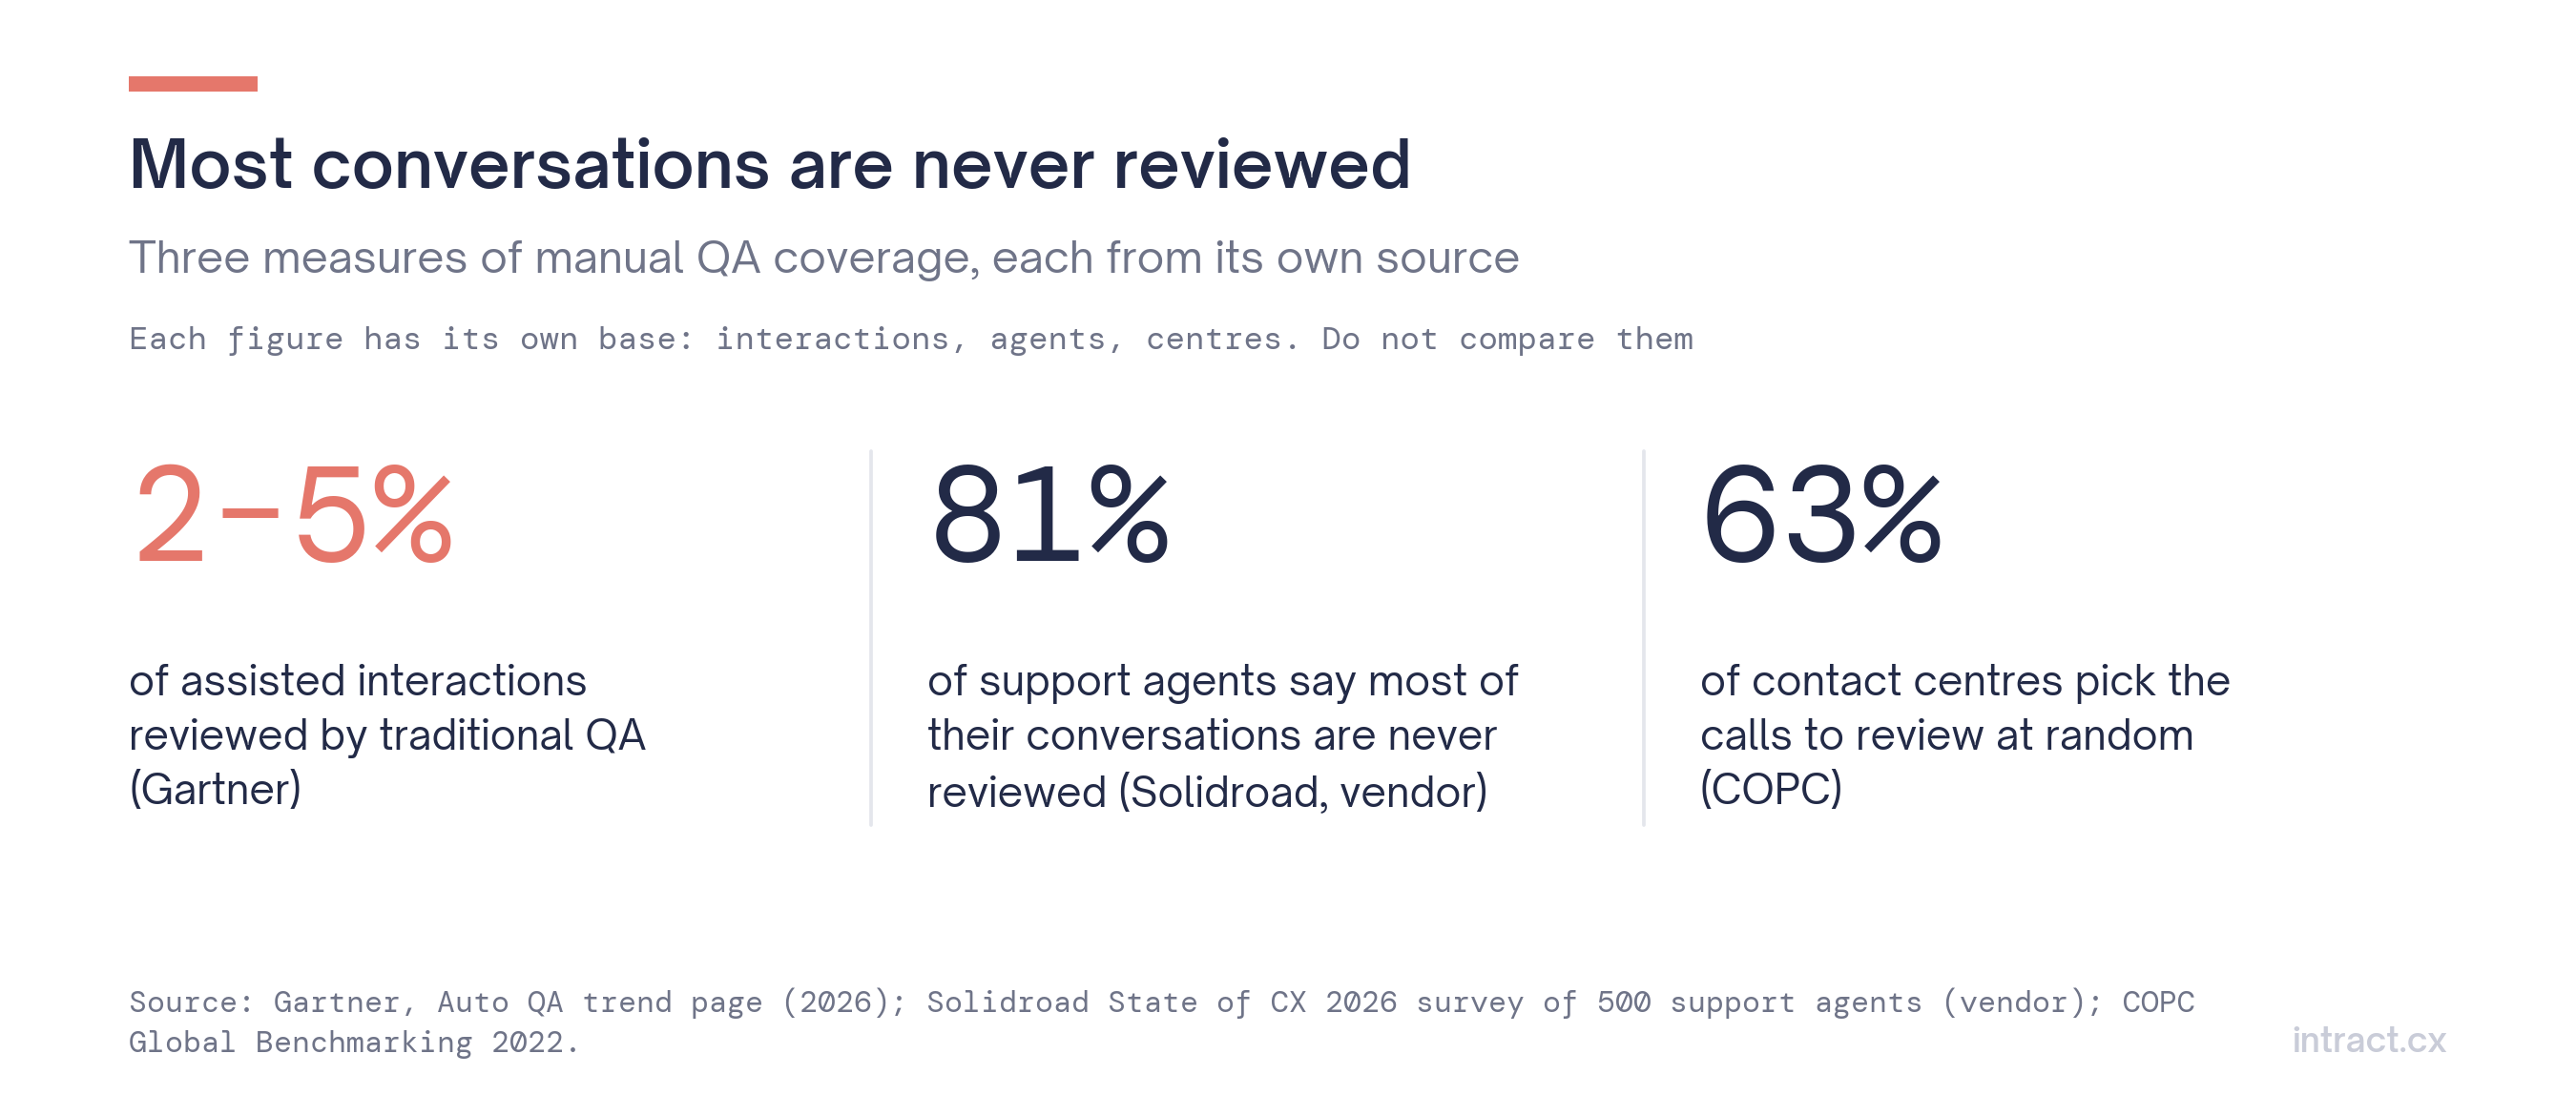 Figuur 1. Dekking van manuele kwaliteitscontrole, volgens Gartner, Solidroad en COPC.
Er circuleert ook vaak een cijfer van "1–2% van de gesprekken". We konden het niet herleiden tot een concrete studie, dus gebruiken we de bandbreedte van 2–5% van Gartner.
2. De vraag die een steekproef niet kan beantwoorden: "Is deze agent compliant?"
Stel dat een agent deze maand 80% scoort op een compliancegrid over de gesprekken die u beluisterd hebt. Hoe zeker kunt u zijn dat zijn werkelijke percentage dicht bij 80% ligt?
We berekenden het 95%-betrouwbaarheidsinterval (Wilsonmethode) rond een waargenomen 80% bij verschillende steekproefgroottes.
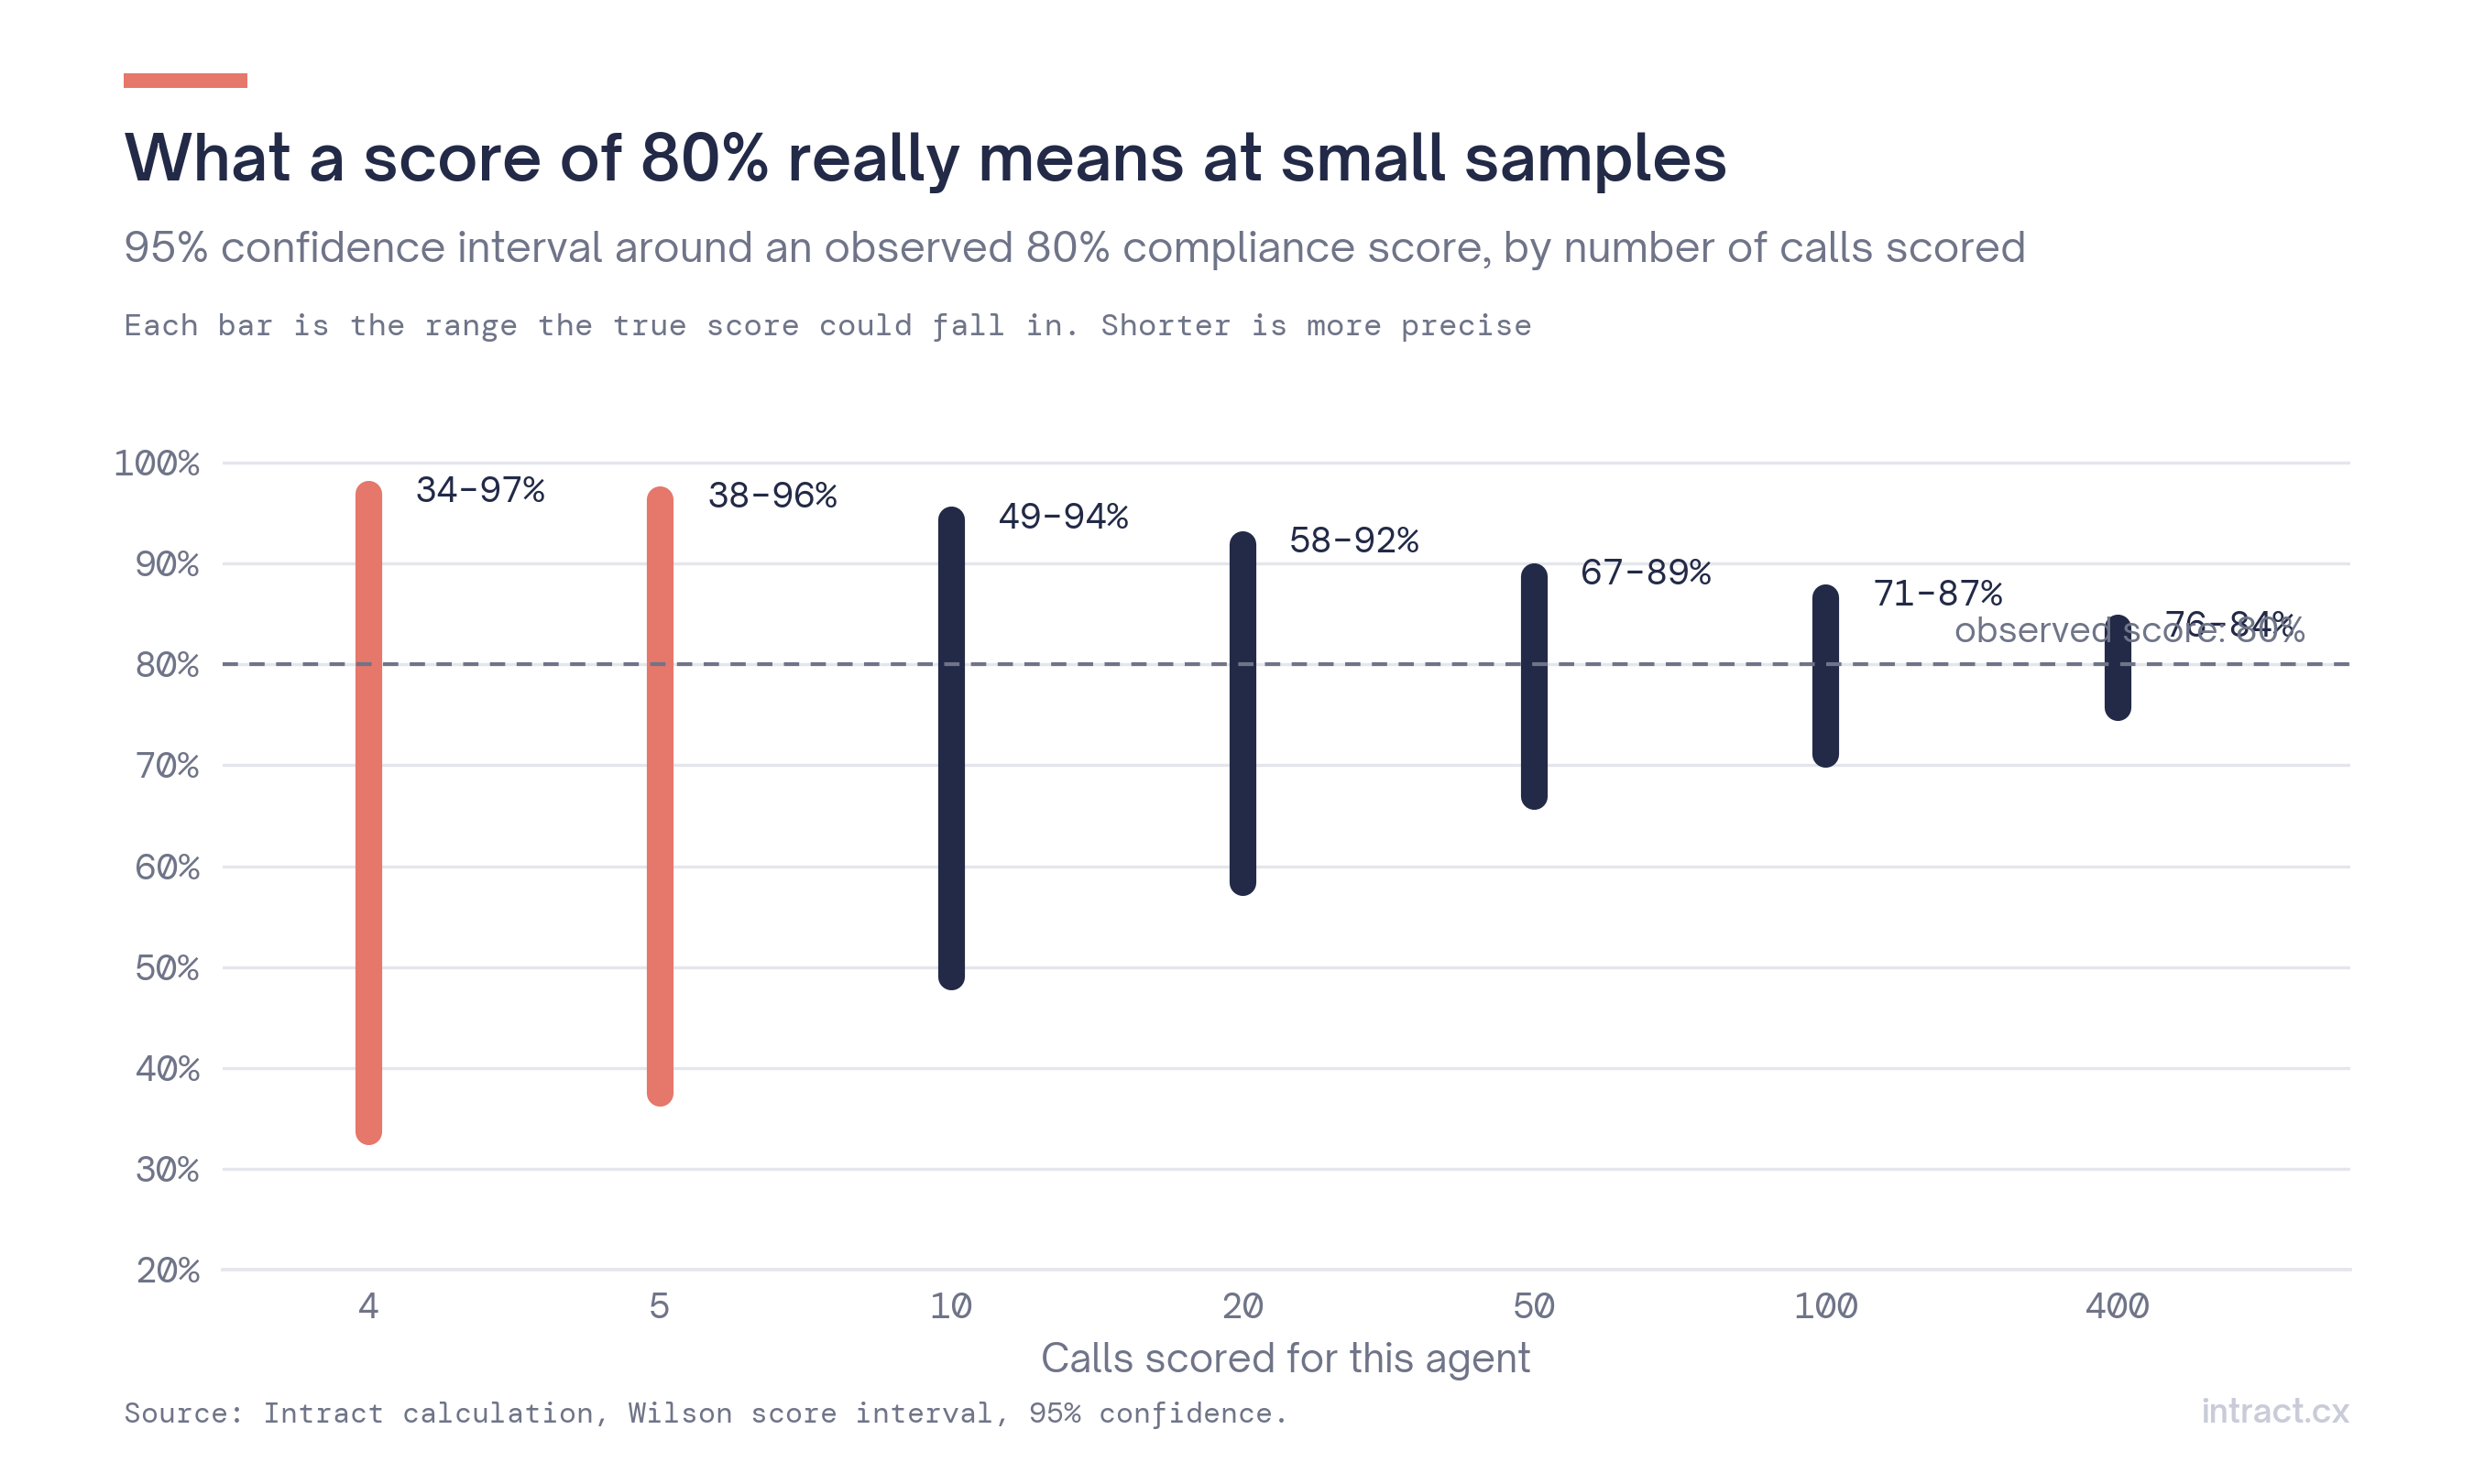 Figuur 2. Bij 4 gescoorde gesprekken is een waargenomen 80% verenigbaar met alles tussen 34% en 97%.
| Gescoorde gesprekken | 95%-interval rond een waargenomen 80% |
|---|---|
| 4 | 34% – 97% |
| 5 | 38% – 96% |
| 10 | 49% – 94% |
| 20 | 58% – 92% |
| 50 | 67% – 89% |
| 100 | 71% – 87% |
| 400 | 76% – 84% |
Bij de steekproefgroottes die de meeste teams hanteren (3 tot 5 gesprekken) beslaat het interval meer dan 50 punten. Dat is breed genoeg om dezelfde agent als "moet beter" of als "uitstekend" te beoordelen, afhankelijk van welke gesprekken getrokken werden. Dat is geen kritiek op de beoordelaars. Het is rekenkunde.
Het verklaart ook een deel van de scoreverschillen die QA-teams vaststellen. Volgens ICMI moeten teams die met kalibratie beginnen rekenen op 20–30% verschil tussen beoordelaars, wat met oefening daalt tot ongeveer 5%. Steekproefruis en beoordelaarsruis tellen bij elkaar op.
3. De vraag die een steekproef slecht beantwoordt: "Missen we zeldzame problemen?"
Veel van de belangrijkste problemen zijn zeldzaam: een verplichte vermelding die vergeten wordt, een klant die dreigt naar de ombudsman te stappen, een verkeerd verkocht product. Als een probleem voorkomt in een fractie van de gesprekken van een agent en u beluistert er willekeurig , dan is de kans dat u het minstens één keer ziet .
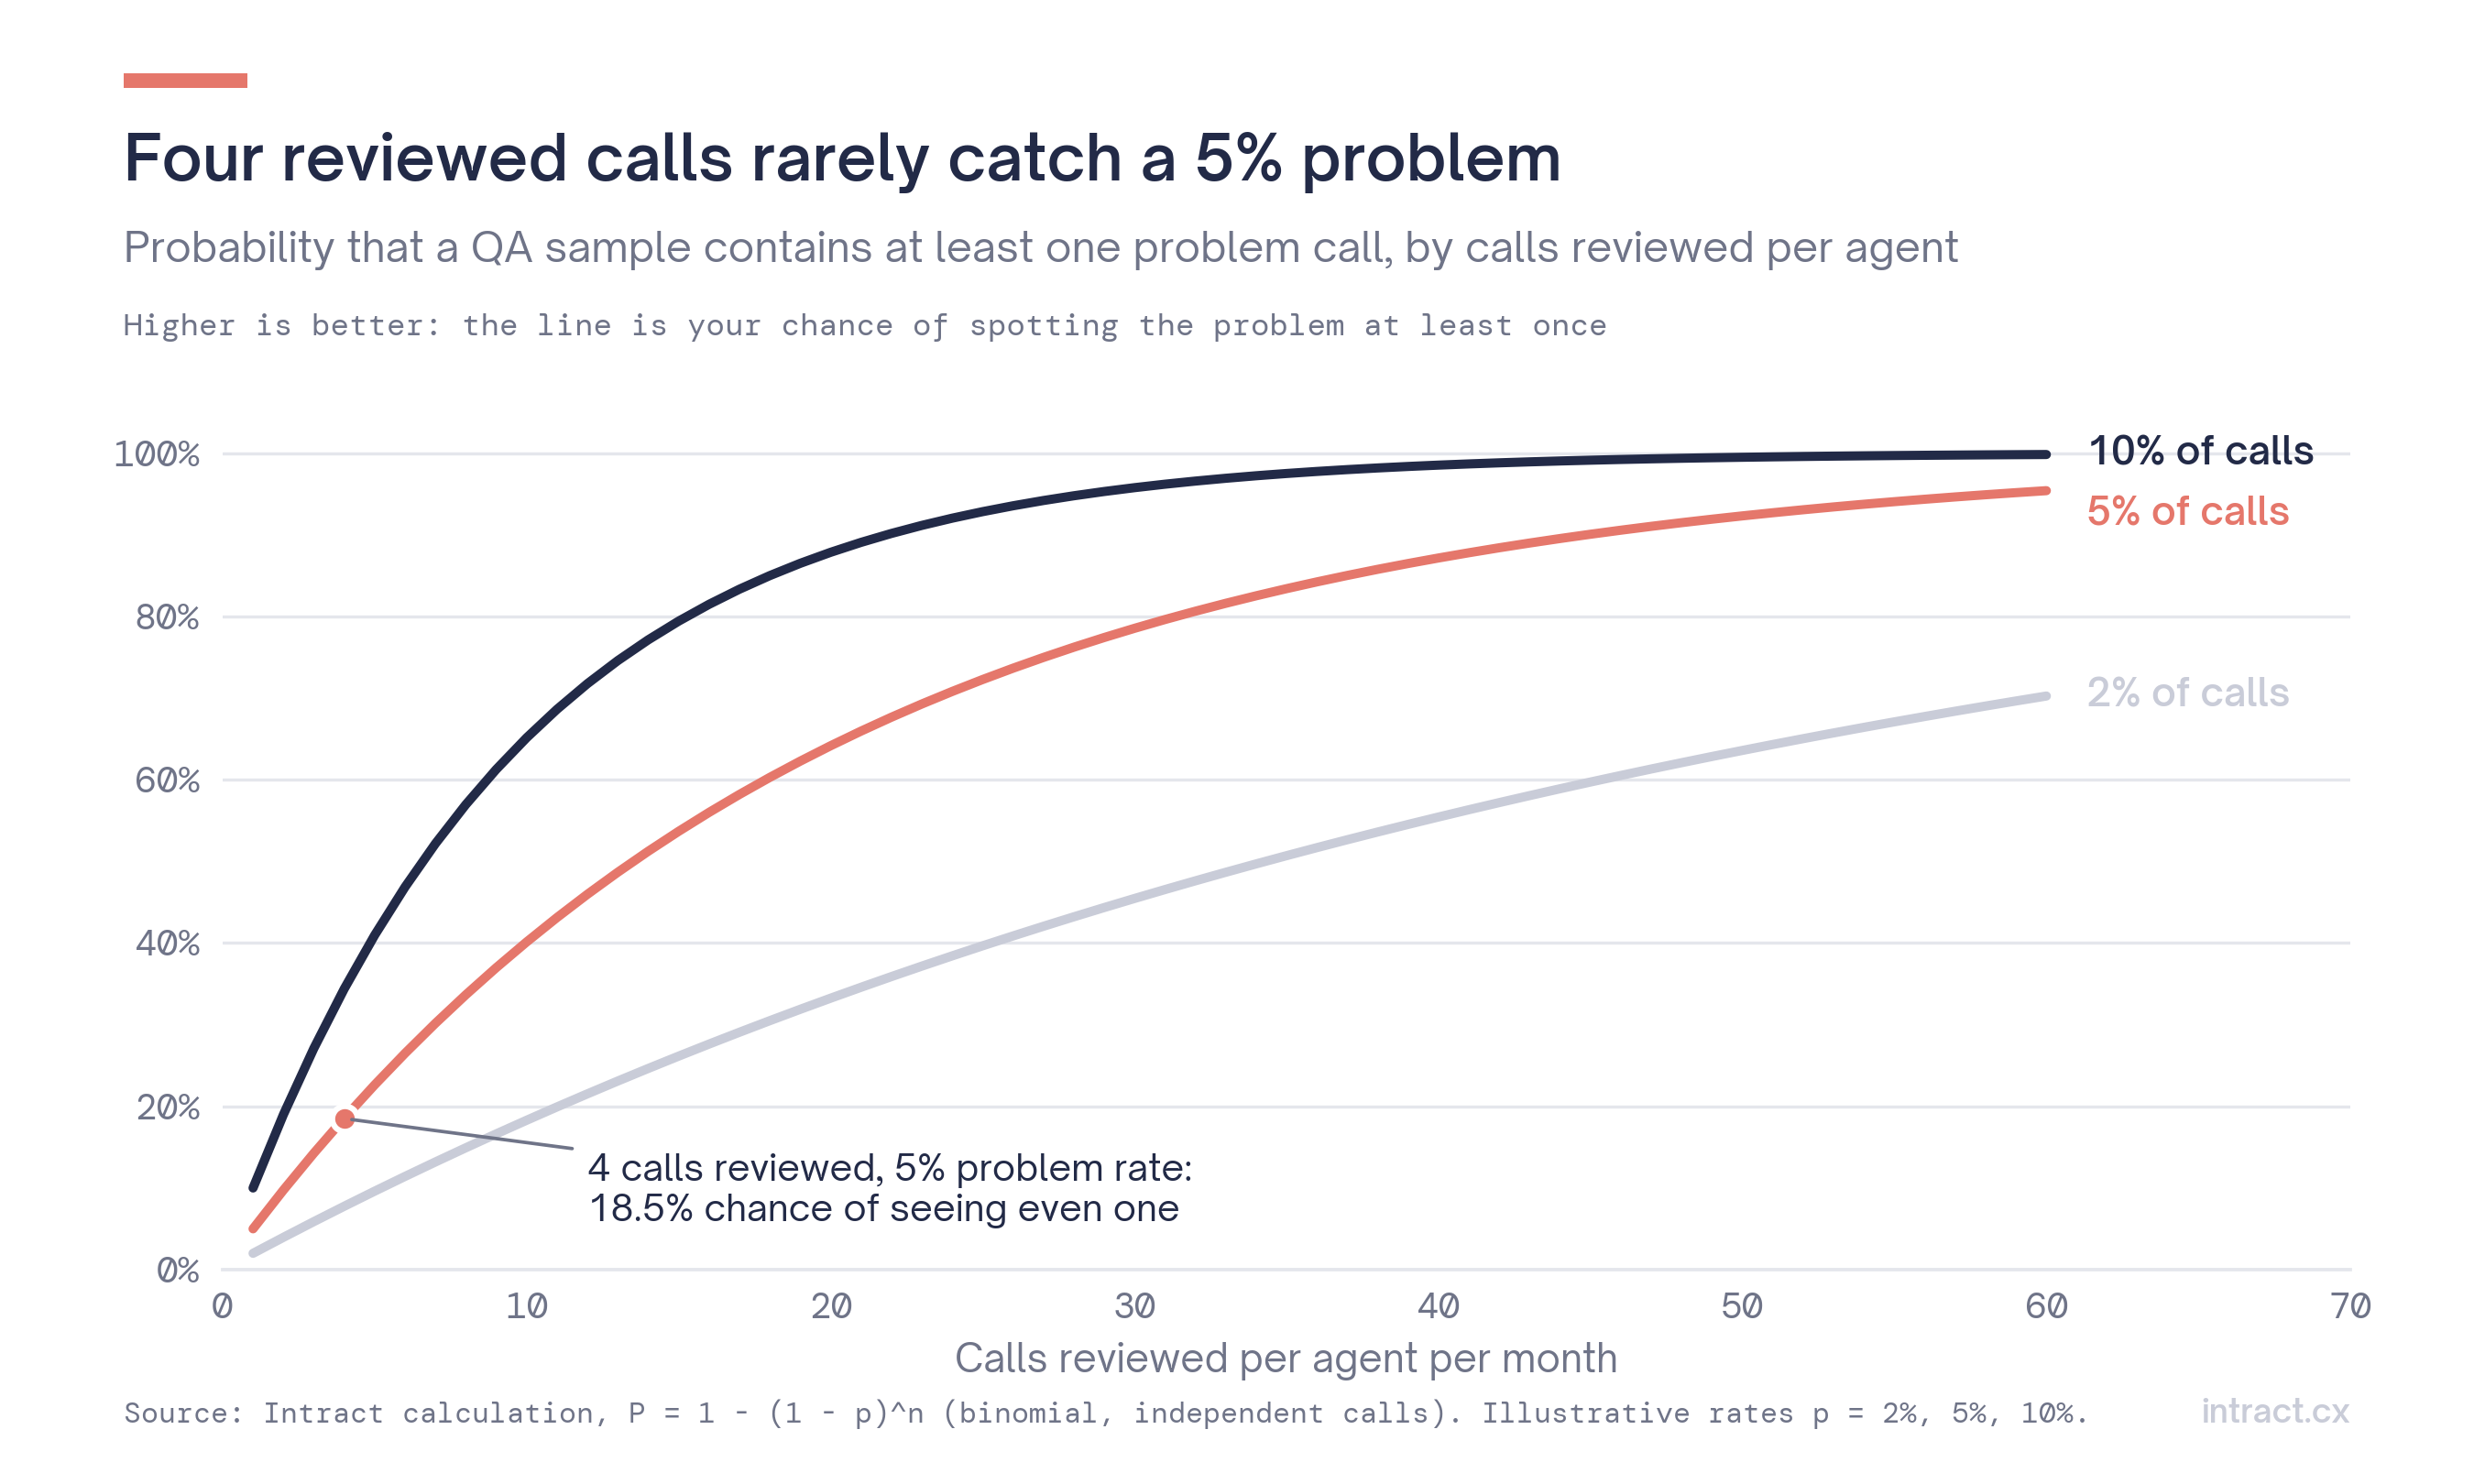 Figuur 3. Wie 4 gesprekken per agent beluistert, merkt een probleem met een frequentie van 5% in 18,5% van de gevallen op.
| Frequentie van het probleem | 4 gesprekken | 10 gesprekken | 30 gesprekken | 60 gesprekken |
|---|---|---|---|---|
| 2% van de gesprekken | 7,8% | 18,3% | 45,5% | 70,2% |
| 5% van de gesprekken | 18,5% | 40,1% | 78,5% | 95,4% |
| 10% van de gesprekken | 34,4% | 65,1% | 95,8% | 99,8% |
Lees de rij van 5% nog eens. Een probleem in één op twintig gesprekken, een frequentie die de meeste complianceteams ernstig zouden vinden, blijft voor een gemiddelde agent vier maanden op vijf onopgemerkt.
4. Waar een steekproef goed in is
Een steekproef is niet nutteloos. Het is een goed instrument voor twee dingen:
- Trends voor het hele center. Voor een percentage over de hele organisatie is de foutmarge bij 95% ongeveer . Ongeveer 385 gesprekken geven ±5 punten, wat overeenkomt met de ~400 gesprekken die praktijkmensen noemen voor die precisie.
- Coachingsgesprekken. Een beoordelaar die samen met een agent naar een gesprek luistert, levert iets op wat geen enkele score geeft: context, toon, een concreet voorbeeld om te bespreken. SQM meldt dat 71% van de centers agents coacht op basis van vier of meer geëvalueerde gesprekken.
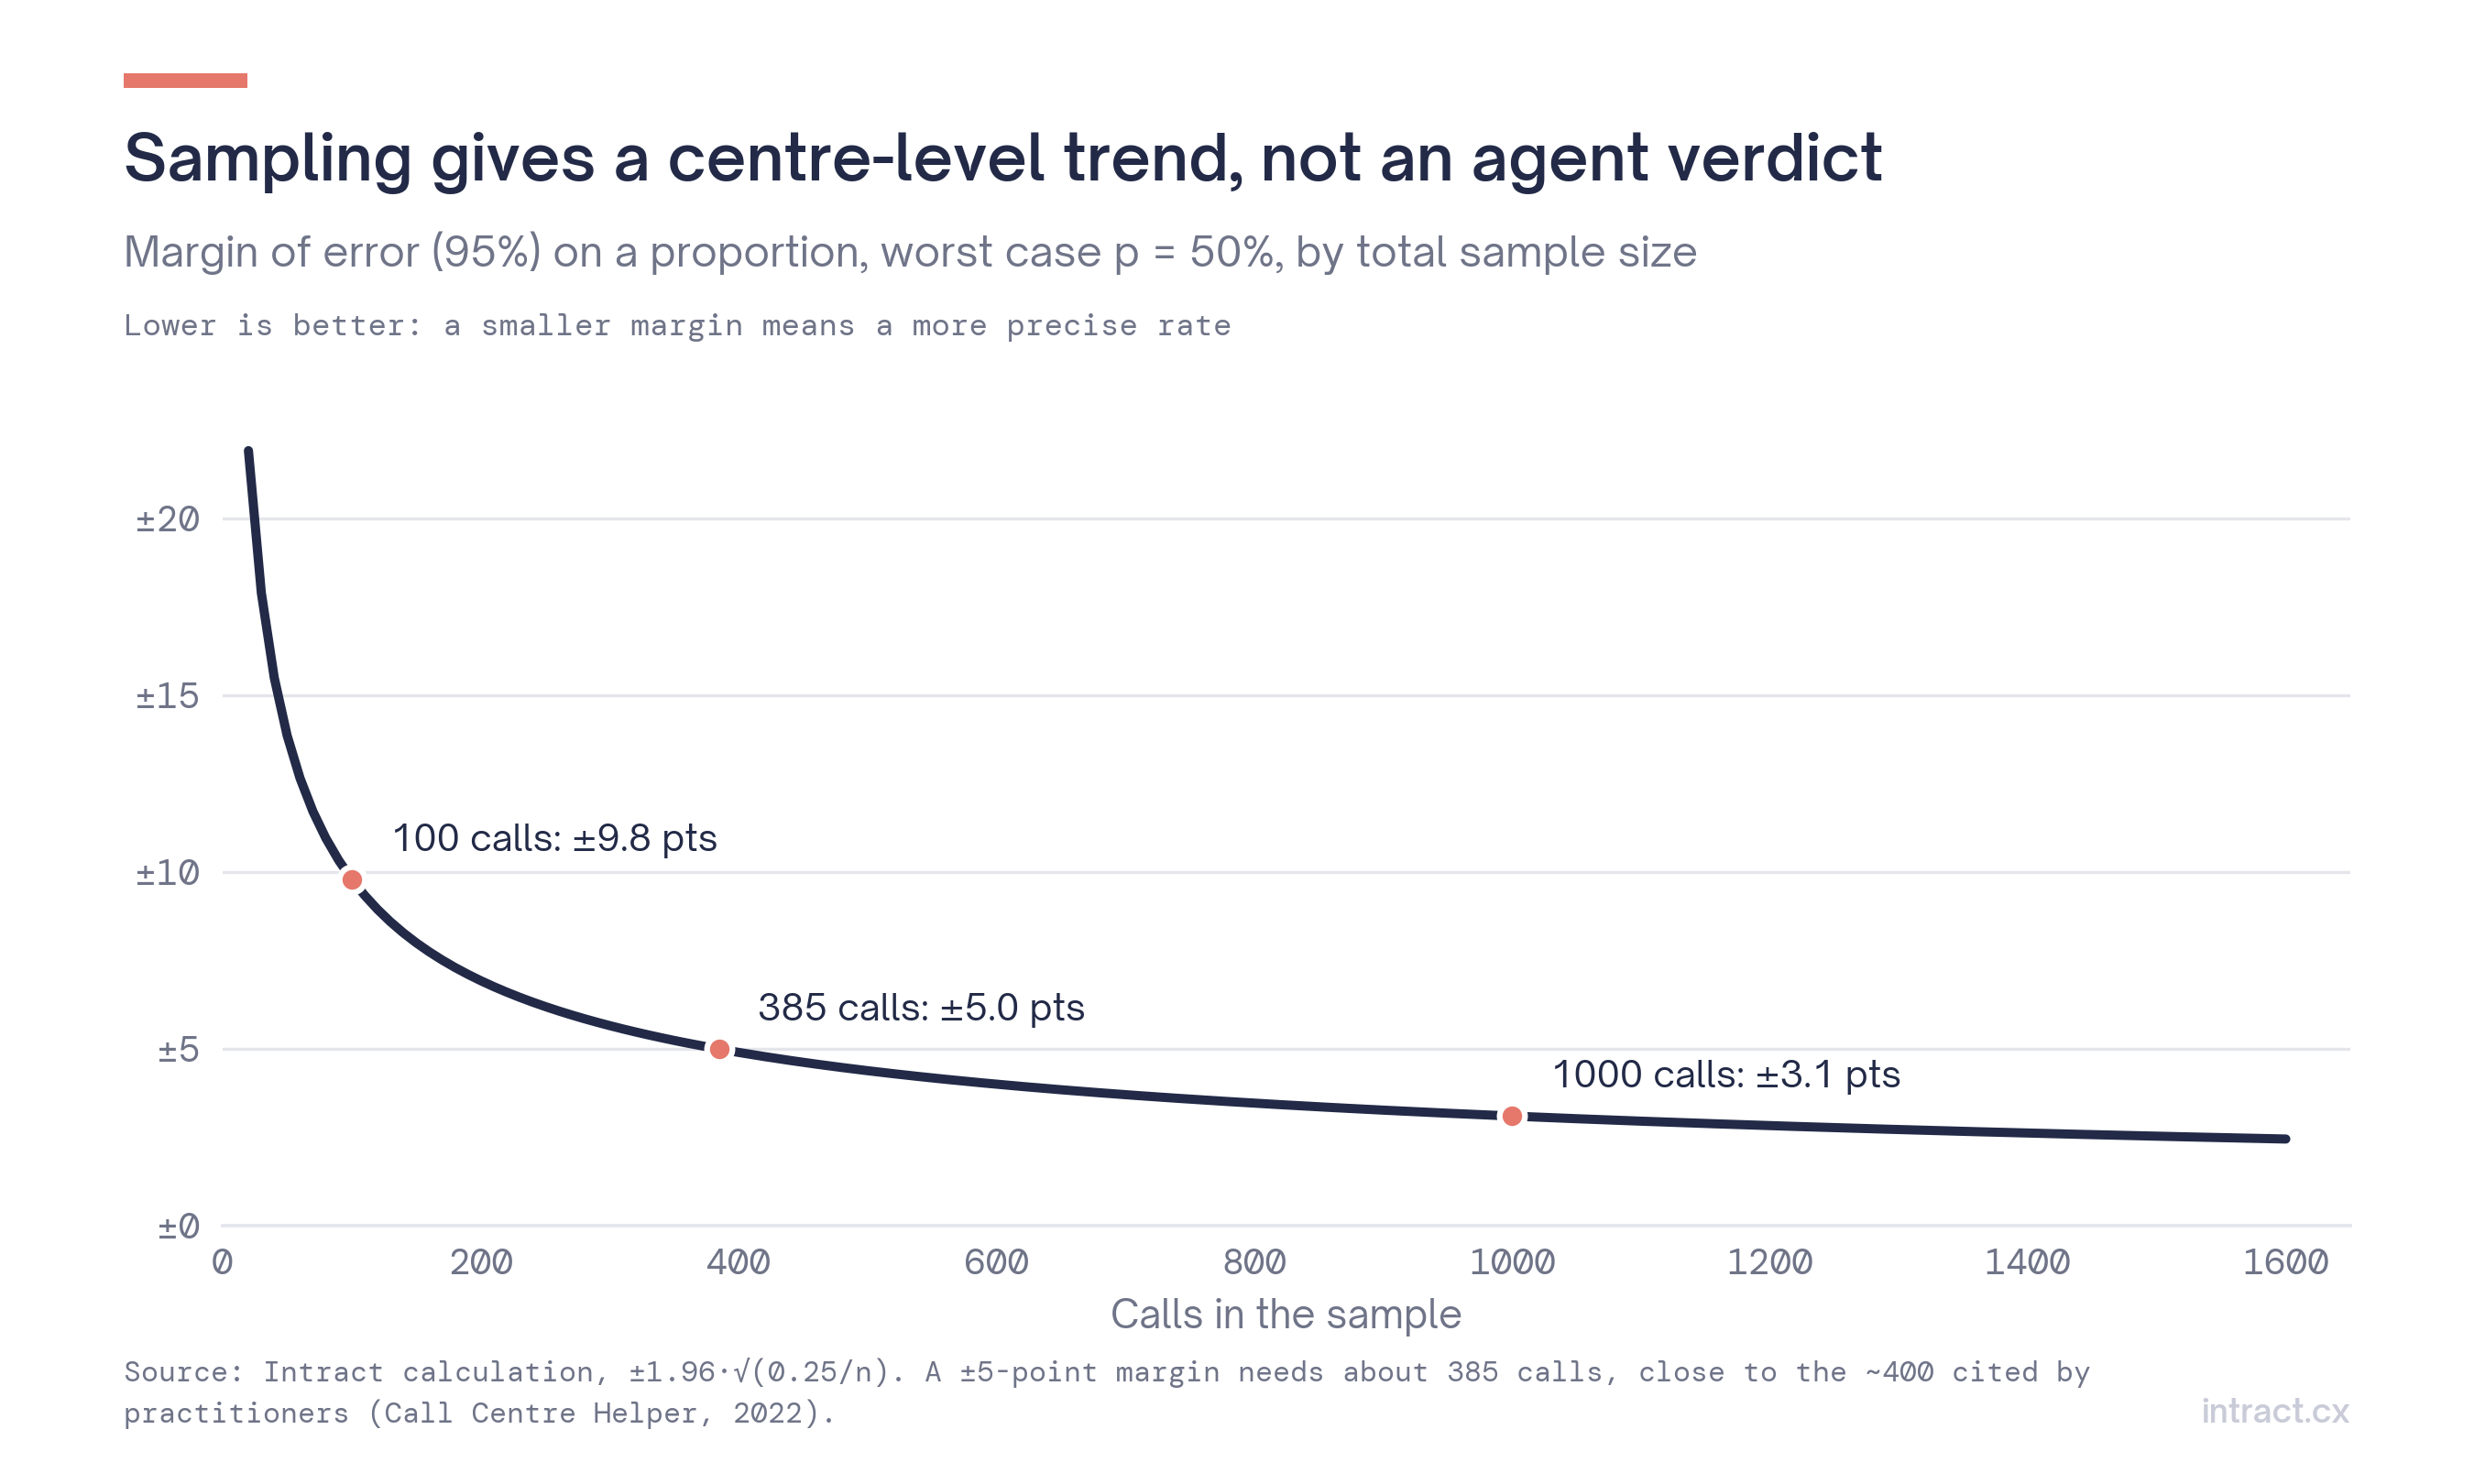 Figuur 4. De foutmarge op centerniveau daalt snel tot een paar honderd gesprekken en vlakt daarna af.
Het probleem begint wanneer een steekproef die voor trends bedoeld is, gebruikt wordt om individuen te beoordelen of om te bewijzen dat een regel nageleefd werd.
5. Wat analyse van 100% verandert
Elk gesprek analyseren neemt de steekproeffout volledig weg. Wat overblijft, is de nauwkeurigheid van de scoring zelf, en die kunt u meten.
| Vraag | Steekproef (3–5 gesprekken/agent) | Analyse van 100% |
|---|---|---|
| Trend voor het hele center | Goed met ~400 gesprekken | Exacte telling |
| Compliancepercentage per agent | ±30 punten of slechter | Enkel beperkt door de nauwkeurigheid van de scoring |
| Een probleem van 5% bij één agent in een maand opsporen | ~1 kans op 5 | Elk voorval gemarkeerd |
| Waar beoordelaars hun tijd aan besteden | Willekeurige gesprekken | Gesprekken die als twijfelachtig gemarkeerd zijn |
| Bewijs voor een auditor | Een steekproef | Elk gesprek, gescoord |
De adoptie neemt toe. In de benchmark 2022 van COPC bij grote organisaties gebruikte 79% al speech analytics voor kwaliteitscontrole. Die steekproef helt over naar mature organisaties, dus de bredere markt ligt lager, maar de richting is duidelijk.
6. Een praktisch model: alles scoren, de juiste gesprekken beluisteren
Het doel is niet om beoordelaars te vervangen. Het is om te veranderen waar ze naar luisteren.
- Automatiseer de objectieve controles op 100% van de gesprekken. "Werd de prijs vermeld?", "Werd de bedenktijd vermeld?" Dat zijn ja/nee-vragen met een citaat om het antwoord te staven.
- Stuur twijfelachtige gesprekken door naar mensen. Scores met lage betrouwbaarheid, niet-nageleefde kritieke punten, aarzeling bij de klant.
- Behoud een kleine willekeurige steekproef voor kalibratie en voor problemen waar niemand aan dacht om ze te automatiseren.
- Coach op patronen, niet op anekdotes. "U vergeet de bedenktijd te vermelden in 30% van uw verkoopgesprekken" is een beter coachingsgesprek dan "in dit gesprek bent u het vergeten".
Hoe Intract hierbij helpt
Intract analyseert elk gesprek dat het ontvangt (native vanuit Aircall en Vonage, of via zijn Audio- en Tekst-API's). Uw QA-grid wordt een no-code workflow: een gestructureerde AI-stap scoort elke vraag OK of niet OK, met de transcriptie op één klik; aggregatiestappen berekenen compliancepercentages en het aantal tekortkomingen, en de resultaten worden filterbare kolommen en dashboards per team en periode. Voor u een grid publiceert, kunt u die op een steekproef van recente gesprekken laten lopen en elk antwoord als juist of fout markeren, zodat u een nauwkeurigheidsscore per kolom krijgt. Kritieke tekortkomingen kunnen een melding in Microsoft Teams activeren.
In een pilot met een Europese consumentenkredietverstrekker werd deze aanpak gebruikt om een verzekeringsverkoopscript van acht vragen op 100% van de gesprekken te controleren.
FAQ
Hoeveel gesprekken moeten we per agent per maand beluisteren? Voor coaching is 3 tot 5 goed gekozen gesprekken een redelijk ritme. Om compliance te beoordelen volstaat geen enkele kleine steekproef: bij 4 gesprekken heeft een score van 80% een 95%-interval van 34–97%.
Is een willekeurige steekproef beter dan een gekozen steekproef? Een willekeurige steekproef vermijdt vertekening, maar kost tijd aan routinegesprekken. Zodra elk gesprek automatisch gescoord wordt, kiest u gesprekken doelbewust (niet-nageleefde kritieke punten, lage betrouwbaarheid) en behoudt u een kleine willekeurige steekproef voor kalibratie.
Vervangt analyse van 100% ons QA-team? Nee. Ze neemt het tellen weg en wijst beoordelaars op de gesprekken die een oordeel vragen.
Methodologie en bronnen
Berekeningen (Intract). Detectiekans: , uitgaande van onafhankelijke gesprekken. Betrouwbaarheidsintervallen: Wilson-scoreinterval, . Foutmarge: , in het slechtste geval . Alle cijfers kunnen in een spreadsheet worden nagerekend.
Bronnen.
- Gartner, Evaluate 100% of Service Interactions With Auto QA (2026)
- SQM Group, Call center quality assurance tips
- COPC, Global Benchmarking Series 2022: Contact Center Quality Assurance
- Call Centre Helper, QA staff to agent ratio en Number of calls analysed (2022)
- ICMI, Three essential quality management metrics (2020)
- Solidroad State of CX 2026, via Stacker (enquête van een leverancier, 500 agents)